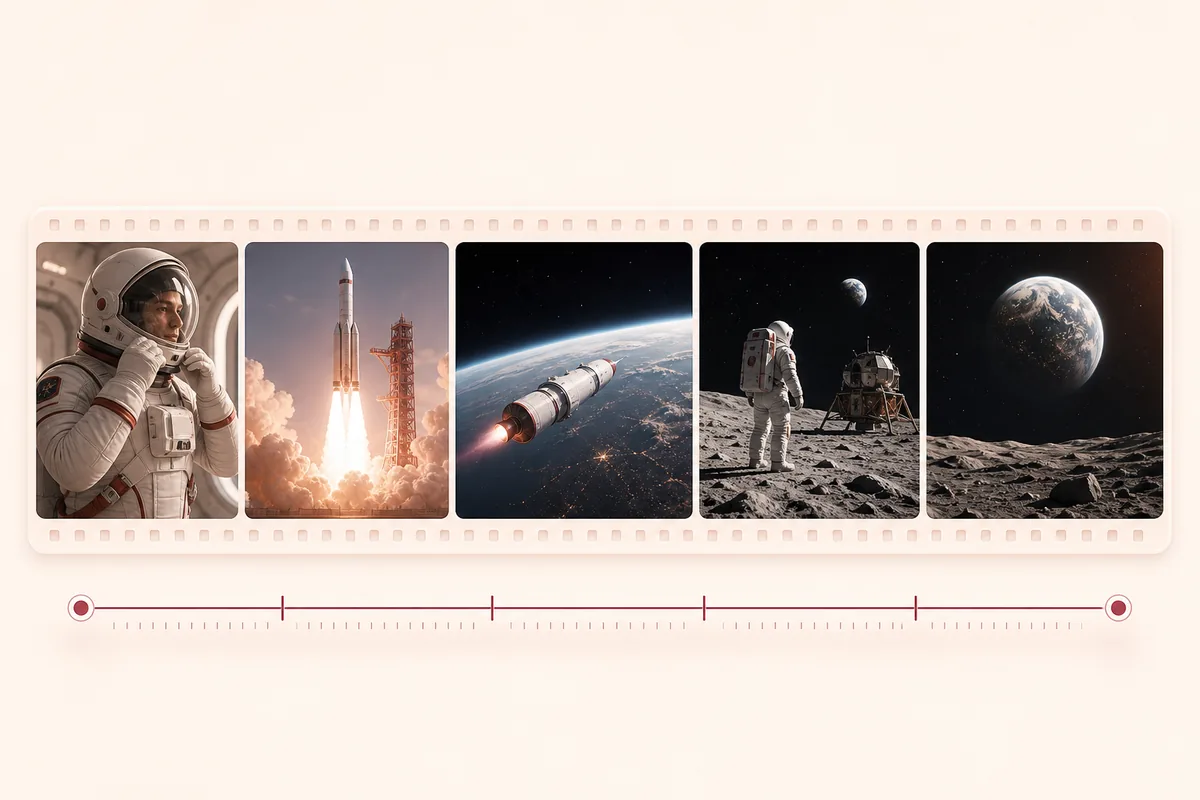
单提示词 20 秒多镜头
一个提示词承载一整段叙事:Flux 3 可以把多个镜头串成最长 20 秒的连续故事,人物、光线与节奏在剪切之间保持连贯。
Flux 3 是 Black Forest Labs 面向视频、图像与音频的多模态 AI 模型。Tryonr 尚未接入其生成 API,因此你现在可以直接使用本页的 Seedance 2.0 现役工作台创作。
Flux 3 即将上线 · Seedance 2.0 本页可用
Flux 3 生成接口尚未接入,因此下方完整工作台当前调用真实的 Seedance 2.0,无需跳转到其他页面。Flux 3 API 一旦开放,我们会第一时间在这里完成接入。
下方生成的每个视频都会按 Seedance 2.0 生成、计价并标注,绝不会冒充 Flux 3,也不会在后台偷偷替换模型。
仅凭提示词生成 4–30 秒带同步音频的视频
详细描述运动方式、镜头角度、光影和氛围以获得最佳效果
1080p 当前仅适用于 Standard 纯文本生视频。
输入提示词或上传图片,点击生成
输入提示词
描述你的视频或上传图片
自定义设置
设置时长、分辨率等参数
生成视频
AI为你创建带音频的视频
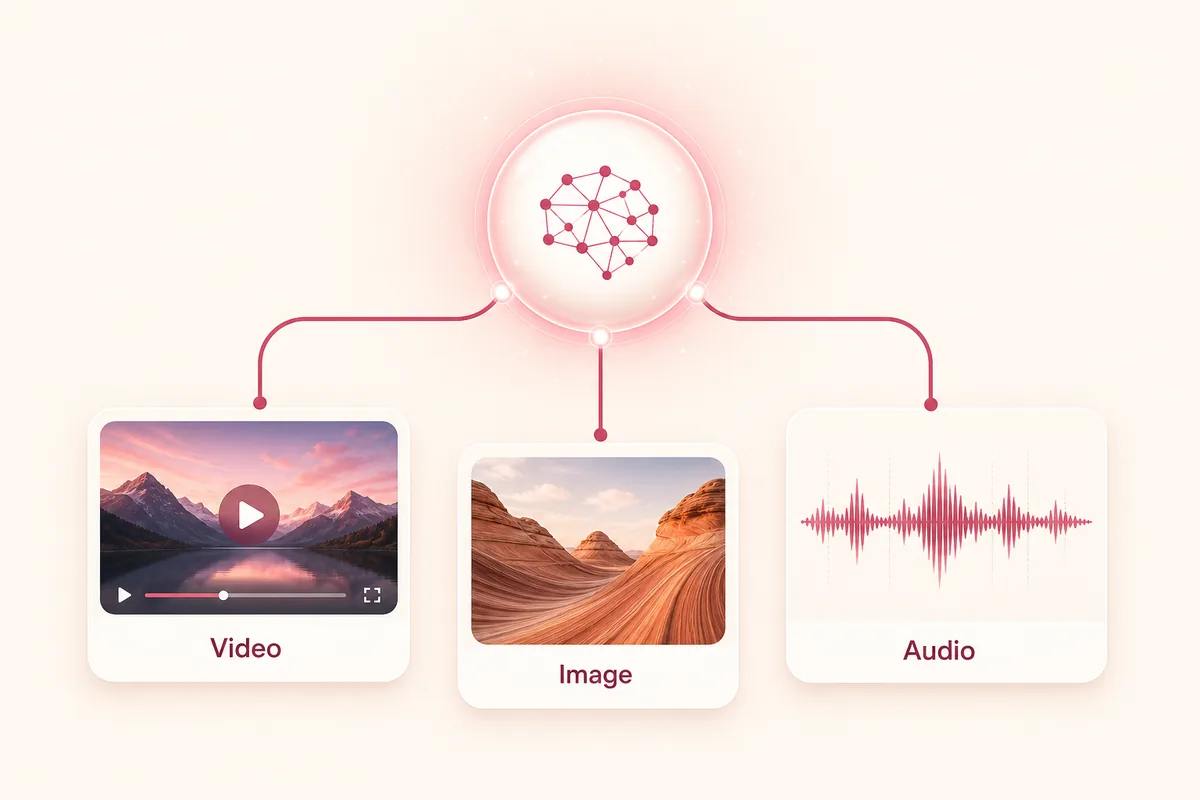
Flux 3 是 Black Forest Labs(BFL)推出的新一代 AI 模型。与此前专注静态图像的 FLUX 系列不同,Flux 3 以统一架构同时训练图像、视频、音频与动作预测——同一个模型既理解画面,也理解它如何运动、如何发声。
Flux 3 于 2026 年 7 月 23 日发布,标志着 BFL 正式进入视频生成领域。早期测试者形容它的作品在每种风格里都更接近真实:皮肤质感、自然运动、连贯光影,这些细节让 AI 视频看起来像实拍素材。
由于 Flux 3 跨模态联合训练,同一个提示词可以驱动一帧静态画面、一段运动镜头或同步的声音。这与把多个模型拼接成流水线的做法截然不同——也正因如此,Flux 3 的对话场景口型自然、物理动作扎实。
Flux 3 视频功能已进入抢先体验阶段。Black Forest Labs 于 2026 年 7 月 23 日开放第一批名额,随后通过合作平台和限时公开预览逐步扩大范围。完整公开发布日期尚未公布——本页会持续跟进最新进展。
抢先体验的片段展示了单次生成的容量:一个提示词最多输出 20 秒多镜头视频,角色可以开口说话,还能生成仿佛出自档案馆的年代感影像。
目前的访问渠道是 BFL 官方的抢先体验计划和合作方举办的短期公开预览,名额有限且窗口很短——这正是提前把提示词准备好的价值所在。
Tryonr 正在推进 Flux 3 的接入。开放之前,可直接使用嵌入在本页的完整 Seedance 2.0 生成器——每条产出都会清楚标注实际使用的模型。
抢先体验阶段展现出的四项长板,以及它们对你的视频意味着什么。
一个提示词承载一整段叙事:Flux 3 可以把多个镜头串成最长 20 秒的连续故事,人物、光线与节奏在剪切之间保持连贯。
Flux 3 在生成画面的同时生成语音、环境音与音效。测试者用一个模糊话题作提示词就得到了自然的对白——无需单独配音,无需手动对轨。
从写实影像到风格化动画,Flux 3 把小细节做扎实:可信的皮肤、织物与光线,以及让历史场景像档案影像的年代质感。
FLUX 系列以听话著称,Flux 3 延续了这一点:复杂的场景描述、运镜指令和情绪提示都能落到画面里,而不是被模型忽略。
今天直接使用本页的 Seedance 2.0 现役工作台;API 开放后切换为 Flux 3。
直接在本页现役工作台描述场景、主体、运镜和氛围。
在嵌入的 Seedance 2.0 生成器中选择时长、生成模式、分辨率、画面比例、音频和批量数量。
无需离开页面即可生成。结果会标注为 Seedance 2.0;Flux 3 API 开放后会第一时间切换接入。
BFL 新模型相对前代与当前主流视频生成器的位置。
| 对比项 | Flux 3 | Flux 2 | Seedance 2.5 | Kling 3 |
|---|---|---|---|---|
| 模态 | 视频、图像、音频 | 仅图像 | 视频 | 视频 |
| 最长片长 | 20 秒多镜头 | — | 30 秒单镜头 | 10 秒 |
| 原生音频 | 支持,含对白 | 不支持 | 未公布 | 未公布 |
| 突出长板 | 真实感与对白 | 静态图像质量 | 4K 单镜头长度 | 运动控制 |
| 当前状态 | 抢先体验中 | 已可用 | 灰度开放中 | Tryonr 已上线 |
以上参数基于 2026 年 8 月的公开信息与抢先体验反馈,官方细节公布后会持续更新。Kling 3 与 Seedance 2.0 现已在 Tryonr 上线;Flux 3 与 Seedance 2.5 即将开放。
多模态设计打开了过去需要三个工具才能完成的格式。
把带对白的多镜头段落串成完整场景——每个节拍一个提示词,音频自带,无需单独混音。
早期测试发现 Flux 3 极擅长年代影像:90 年代的教室、复古采访、纪录片质感的场景,旧得恰到好处。
会动、会说、音效贴合品牌的产品镜头,一次生成一条完整素材,而不是视频、配音、混音三道工序。
为 TikTok、Reels 和 Shorts 生成竖版对白短片——角色吐槽、反应、抖包袱,全部从一句文字创意开始。
目前看 Flux 3 最直接的窗口是 Black Forest Labs 的官方发布贴和随后的公开预览——多镜头短片、对白场景与风格测试,全部来自第一手来源。
本页不放任何假样片:Tryonr 上展示的每一条视频都由其标注的模型生成。我们的访问权限开通当天,真实的 Flux 3 案例就会出现在这里。
外部链接指向 Black Forest Labs 在 X 上的官方帖子。
关于开放时间、功能与准备方式的快速解答。
Flux 3 于 2026 年 7 月 23 日发布,视频生成目前处于抢先体验阶段,通过 BFL 官方和合作方预览分批开放,完整公开发布日期尚未公布。先在 Tryonr 保存提示词,窗口打开时即可抢先生成。
Flux 3 是 Black Forest Labs 的多模态 AI 模型——一个统一架构同时生成视频、图像与音频,并具备动作预测能力。它继承 FLUX 图像系列,但把能力扩展到了会动、有声的完整场景。
能。音频与视频原生同步生成,包括角色对白。早期测试者用非常模糊的提示词就得到了自然的语音,口型与表演和场景匹配。
抢先体验显示单次生成最长 20 秒,且一个提示词可覆盖多个镜头。随着开放推进,可能出现更长的格式。
抢先体验名额有限,官方预览期间部分免费。完整定价尚未公布。在 Tryonr 上,今天保存 Flux 3 提示词免费,上线后生成将使用 Tryonr 积分。
Flux 2 生成静态图像;Flux 3 在一个联合训练的模型里加入了视频、音频与动作预测——一个提示词直接产出带声音的成片,而不是一帧画面。
两者定位不同:Flux 3 强在多模态真实感与对白,Seedance 2.5 主打原生 4K 与 30 秒单镜头。建议在 Tryonr 上按项目各取所长——Seedance 2.5 的详细规格见对应页面。
我们正在推进 Flux 3 的接入,API 权限开放后会第一时间上线。在此之前,本页已经直接提供完整的 Seedance 2.0 生成器,所有结果都会清楚标注真实模型。
今天使用本页的 Seedance 2.0 现役生成器;Flux 3 API 开放后会在这里第一时间接入。
无需跳转 · 每个结果都标注真实生成模型
对比新一波模型,或现在就开始生成。